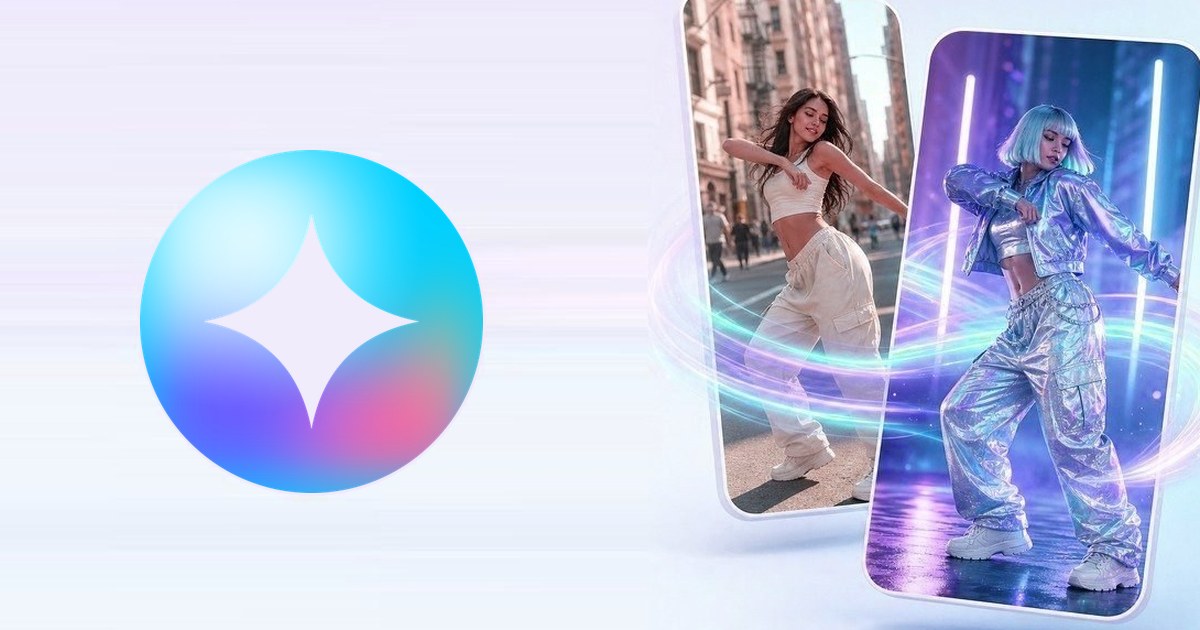
Negli ultimi anni i modelli di intelligenza artificiale per il video sono passati dai laboratori di ricerca agli strumenti di uso quotidiano. Una delle applicazioni più intuitive è il motion transfer, o trasferimento del movimento: si prende il movimento di una persona da un video e lo si fa eseguire a un altro personaggio, rappresentato in una semplice immagine. In questo articolo vediamo, senza formule, quali sono le fasi principali del processo e da cosa dipende la qualità del risultato.
Gli ingredienti di partenza
Il motion transfer lavora con due input. Il primo è il video di riferimento, che contiene il movimento: una camminata, una serie di gesti, un passo di danza. Il secondo è l’immagine del personaggio, che stabilisce l’aspetto del risultato: lineamenti, abiti, colori, stile grafico. L’obiettivo è ottenere un video nuovo in cui il personaggio dell’immagine si muove come la persona del video, mantenendo il proprio aspetto.
Fase 1: capire la posa in ogni fotogramma
Il primo passaggio è la stima della posa. Il modello analizza ogni fotogramma del video di riferimento e individua i punti chiave del corpo, come testa, spalle, gomiti, polsi, anche, ginocchia e caviglie. Mettendo in fila queste informazioni si ottiene una sorta di scheletro in movimento, una rappresentazione astratta del gesto che non contiene più l’aspetto della persona ripresa ma solo la sua postura nel tempo.
Fase 2: capire il personaggio
In parallelo il sistema analizza l’immagine del personaggio per coglierne le caratteristiche visive: forma del corpo, proporzioni, vestiti, texture e stile. È questa parte a garantire che, nel video finale, il personaggio resti riconoscibile da un fotogramma all’altro.
Fase 3: generare il video
A questo punto un modello generativo combina le due informazioni: per ogni istante prende la posa ricavata dal video e “disegna” il personaggio in quella posizione. Un aspetto delicato è la coerenza temporale: i fotogrammi devono susseguirsi in modo fluido, senza che il volto cambi, che i vestiti tremolino o che le mani appaiano e scompaiano. Per questo i modelli moderni non lavorano su immagini isolate, ma tengono conto dei fotogrammi vicini.
Da cosa dipende la qualità
- Leggibilità del video di riferimento. Se il corpo è intero nell’inquadratura, ben illuminato e su uno sfondo semplice, la stima della posa è più precisa.
- Velocità del movimento. Gesti rapidi, giravolte e parti del corpo che si coprono a vicenda rendono più difficile ricostruire la posa.
- Somiglianza delle proporzioni. Un personaggio con proporzioni molto diverse da quelle della persona ripresa può portare a deformazioni.
- Qualità dell’immagine. Un’immagine nitida, a figura intera e in posa neutra offre al modello più informazioni sull’aspetto da mantenere.
- Dettagli fini. Mani, dita e piedi restano le zone più impegnative: vale la pena controllarle con attenzione.
Usi tipici
Chi crea contenuti brevi lo usa per far ballare un avatar sui trend del momento senza comparire in video. Illustratori e piccoli studi lo impiegano per vedere un personaggio in movimento prima di animarlo nel dettaglio. Brand e attività locali possono far muovere la propria mascotte riutilizzando un’unica ripresa per più contenuti.
Responsabilità d’uso
Come per ogni tecnologia generativa, contano le scelte di chi la usa: impiegare solo video e immagini di cui si possiedono i diritti, ottenere il consenso delle persone riprese e segnalare al pubblico quando un contenuto è stato realizzato con l’intelligenza artificiale.
Provare in pratica
Per sperimentare non servono competenze di programmazione: esistono servizi web, tra cui Genjutsu, in cui basta caricare un video di riferimento e l’immagine di un personaggio per ottenere un nuovo video con lo stesso movimento. Partire da clip brevi e movimenti semplici è il modo migliore per capire come reagisce il modello e affinare progressivamente le proprie riprese.
Genjutsu Team | https://genjutsu.app





Commento all'articolo